Por que Resiliência Não É Mais Opcional
E aí, dev! Hoje as organizações enfrentam pressão constante para modernizar. Aplicações críticas estão sendo transformadas, workloads de IA se tornam fundamentais e os ambientes de infraestrutura ficam mais complexos a cada dia. Mas a modernização só dá certo quando você tem confiança de que suas aplicações, dados e infraestrutura aguentam disruption.
Resiliência é a capacidade da infraestrutura e dos workloads de resistir, se adaptar e se recuperar de disruptions mantendo as operações críticas. Historicamente, times abordavam resiliência com backups, redundância e planos de disaster recovery. Isso continua essencial, mas a resiliência moderna exige uma abordagem mais ampla: arquitetura, operações, recuperação e otimização contínua.
A mudança é clara: resiliência não é sobre prevenir toda disruption. É sobre projetar para a incerteza, minimizar impacto operacional, recuperar de forma eficaz e fortalecer continuamente a prontidão. À medida que as organizações adotam aplicações distribuídas, serviços com IA e arquiteturas híbridas/multicloud, resiliência virou requisito de negócio, não só consideração técnica.
Quer entender como frameworks de agentes de IA estão evoluindo? Dá uma olhada na nossa análise do Framework Antigravity do Google.
Resiliente por Design: Construindo Desde o Início
Resiliência começa muito antes de um outage acontecer. As estratégias mais eficazes começam no planejamento e design, com arquiteturas que alinham disponibilidade, recuperação, performance, compliance e requisitos operacionais às necessidades de cada workload. Nem toda aplicação precisa da mesma estratégia.
O Azure ajuda a construir resiliência na infraestrutura desde o início através de:
- Zonas de disponibilidade para isolamento de falhas
- Arquiteturas de rede resilientes
- Opções de armazenamento durável
- Serviços de recuperação
- Guias comprovados do Azure Well-Architected Framework e Azure Architecture Center
O recém-anunciado Azure Infrastructure Resiliency Manager estende essa base. Ele ajuda organizações a definir metas de resiliência, entender criticidade de workloads, identificar gaps e avaliar postura de resiliência no nível da aplicação. Em vez de revisões manuais e avaliações estáticas, os times entendem continuamente como os workloads se alinham aos objetivos.
Para simplificar a adoção, o Resiliency Manager oferece recomendações, guias de deployment e experiências assistidas por IA através do agente de resiliência no Azure Copilot. Os times podem descrever workloads, gerar templates resilientes, avaliar ambientes existentes e receber recomendações alinhadas às suas metas.
O objetivo é simples: fazer resiliência parte de como as aplicações são projetadas, não algo que você revisita só depois de uma disruption.
# Exemplo: Definindo uma meta de resiliência no Azure Infrastructure Resiliency Manager
resiliencyGoal:
  workload: "servico-inferencia-ia"
  criticality: "mission-critical"
  targetRTO: "15m"
  targetRPO: "5m"
  availabilityZones: true
  geoRedundancy: true
  backupPolicy: "immutable-vault-daily"
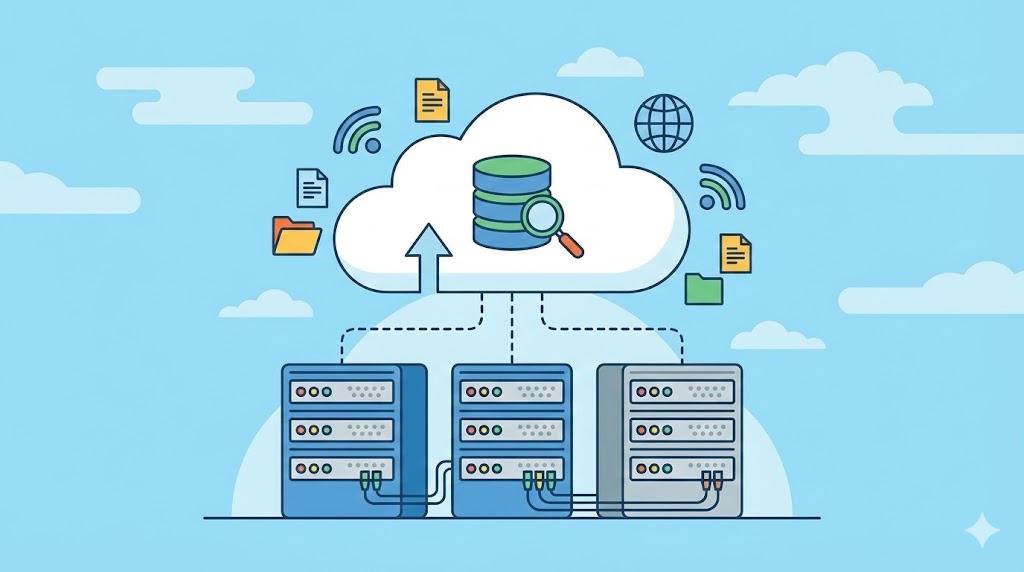
Inove Sem Interrupção: Resiliência Contínua
Modernização não é projeto único. Aplicações evoluem, novos serviços surgem, dependências aparecem e a infraestrutura muda continuamente. Conforme os ambientes evoluem, a resiliência precisa evoluir junto.
Um dos desafios mais comuns é manter continuidade operacional enquanto introduz mudanças. Novos deployments, configuration drift, requisitos de scaling e arquiteturas em evolução podem gradualmente afastar workloads dos objetivos originais de resiliência. O que era resiliente seis meses atrás pode não atender mais aos requisitos atuais.
Por isso a resiliência está se tornando uma prática operacional contínua, não um exercício de design único. O Azure Infrastructure Resiliency Manager ajuda a avaliar continuamente a postura, identificar gaps prioritários e aumentar uptime através de recomendações e gestão centrada na aplicação.
Resiliência por Disco para Azure Managed Disks (Preview Público)
O Azure está embutindo resiliência mais profundamente no stack. A resiliência por disco, agora em preview público em regiões selecionadas, ilustra isso na camada de armazenamento. Tradicionalmente, quando uma VM perdia conectividade com um managed disk por período prolongado, o Azure recuperava a VM após a conectividade ser restaurada. Com resiliência por disco habilitada, o Azure pode temporariamente colocar offline apenas o disco de dados afetado enquanto a VM e os demais discos continuam operando. Após a conectividade ser restaurada, o Azure reconecta o disco automaticamente.
Essa abordagem reduz o blast radius de disruptions isoladas de armazenamento para workloads que toleram perda temporária de um disco de dados individual, incluindo aplicações clusterizadas, workloads com discos auxiliares e certas arquiteturas containerizadas.
Recupere com Confiança: Validação e Resiliência Cibernética
Nenhuma organização consegue prevenir toda disruption. A medida da resiliência é quão eficazmente você se prepara, responde, recupera e aprende com esses eventos.
O Azure ajuda a melhorar a prontidão de recuperação através de backup integrado, disaster recovery, monitoramento e gestão de resiliência. O Azure Chaos Studio permite simular condições de outage—falhas de zona de disponibilidade, failovers de banco de dados, disruptions de DNS e Microsoft Entra—para testar suposições com segurança, verificar procedimentos e construir confiança.
A confiança na recuperação também depende de proteger dados contra ameaças cibernéticas sofisticadas. O Azure Backup oferece vaults imutáveis, soft delete, autorização multi-usuário e orquestração de recuperação para preservar pontos de recuperação limpos e restaurar workloads críticos com confiança—especialmente importante quando a recuperação envolve um ciberataque em vez de falha de infraestrutura.
Atenção, dev: Resiliência por disco e experimentos do Chaos Studio devem ser testados primeiro em ambientes não-produção. Nem todo workload tolera perda temporária de disco—valide o comportamento da aplicação antes de habilitar em produção. Além disso, vaults imutáveis precisam ser configurados antes de um incidente; não podem ser aplicados retroativamente a backups existentes.
Próximos Passos de Aprendizado
- Explore o Azure Well-Architected Framework para guias de confiabilidade
- Teste o Azure Chaos Studio em uma subscription sandbox
- Revise o RTO/RPO do seu workload contra requisitos de negócio
- Para padrões de infraestrutura específicos de IA, veja nossa análise do Foundry IQ

O Futuro da Resiliência é Contínuo
O futuro da resiliência não é simplesmente recuperar mais rápido. É permitir que organizações construam fundações resilientes, operem com confiança conforme os ambientes evoluem e fortaleçam continuamente a prontidão de recuperação.
Principais takeaways:
- Projete para a incerteza—embuta resiliência no planejamento, não após o deployment
- Valide continuamente—use Chaos Studio e Resiliency Manager para testar suposições regularmente
- Reduza o blast radius—resiliência por disco e capacidades self-healing limitam o impacto de falhas isoladas
- Proteja pontos de recuperação—vaults imutáveis e autorização multi-usuário defendem contra ameaças cibernéticas
Para ver essas capacidades em ação, a Microsoft está realizando o episódio "Minimize downtime with resilient cloud applications" da série de webinars em 17 de setembro às 10:00 AM PT, demonstrando Azure Infrastructure Resiliency Manager, Azure Backup, Azure Site Recovery, Azure Chaos Studio e o Azure Copilot Resiliency Agent.
Fonte: Microsoft Azure Blog