ウェブサイトが「リリース直後」に最高の状態になる理由 — 自律エージェント時代の保守戦略まとめ
2026-10-06
リリース直後がピークになってしまうウェブサイトの「自然な劣化」を防ぐ方法と、AIエージェントに何を委任し、何を人間が握るべきかの実務的な基準を整理しました。
記事を読む →78 posts in this category
2026-10-06
リリース直後がピークになってしまうウェブサイトの「自然な劣化」を防ぐ方法と、AIエージェントに何を委任し、何を人間が握るべきかの実務的な基準を整理しました。
記事を読む →
2026-10-05
エージェント運用コストの大部分はモデル単価ではなく、毎ターン再送されるコンテキストから発生します。知識検索・ツールボックス・スキル・メモリの4軸で設計すれば、品質を落とさずコストを削減できます。
記事を読む →
2026-10-03
GPT-4.1ベースのReActエージェントは平均77.4%成功する一方、5回連続成功するタスクは53.0%のみ。この24.4ポイントの「一貫性ギャップ」を診断し、半減させるConsistency Analyzerとガイドライン生成パイプラインを解説します。
記事を読む →
2026-09-28
Metaが広告推薦システムにおいて、オフラインのユーザーモデリングとオンラインランキングを分離したマルチステージ・アーキテクチャを導入し、LLM型の予測可能なスケーリング則を獲得した事例を整理します。Instagramのコンバージョン+6%、Facebookのコンバージョン+3%という実測結果と、シーケンス長・多様性・セマンティック特徴量が性能にどう寄与するかをまとめました。
記事を読む →
2026-09-24
QPSとCPU使用率だけではリアルタイムAIのトラフィックを捌けません。アクティブセッション数を組み合わせたハイブリッド型ロードバランシング戦略と実装コードを整理しました。
記事を読む →
2026-09-23
SpotifyがAI導入後1年間の自社データを分析した結果、「AIが書いたコードが障害を起こした」という証拠は見つからなかった。本当の問題は、コード生産速度に検証システムが追いつけなくなったことだった。本記事では、彼らが発見した4つのリスク領域と対応策を実務視点で整理します。
記事を読む →
2026-09-22
CloudFront + 複数NLB構成でWeightedルーティングが単一IPしか返さずthundering herdを引き起こした実例を解説。Multi-Value Answerルーティングへの変更のみで1億2100万台の同時接続をゼロエラーで処理した構成と、実務での導入手順をまとめます。
記事を読む →
2026-09-08
Adobe Fireflyがセルフマネージド型Prometheusの限界を克服し、Amazon Managed Prometheusへ移行したプロセスを通じて、大規模GPUインフラにおける可観測性(Observability)設計の要点を解説します。クエリ性能28倍向上という実測データとアーキテクチャ進化の過程をまとめました。
記事を読む →
2026-09-05
Azure IaaS環境でコストが増加する根本原因を分析し、コンピューティング、ストレージ、ネットワーク領域ごとの最適化戦略と、継続的な運用改善のアプローチを解説します。
記事を読む →
2026-09-04
ダッシュボードが意思決定に結びつかない根本原因を分析し、チャート作成前の「80%の作業」を定義するデータUX手法を解説します。具体的なB2B SaaSプロジェクトの事例をもとに、文脈・ユーザー・インサイトの3つの問いを立てることで、単なる情報表示ではなく能動的なインサイトを提供するダッシュボード設計の要点を学びます。
記事を読む →
2026-09-02
Cloudflareのコアサーバーでファームウェアアップデート後にブート時間が4時間にまで悪化した問題を、UEFIブートインターフェースの順序宣言とiPXEスクリプト最適化によって3分に短縮したプロセスを詳細に解説する。
記事を読む →2026-09-01
NetflixがCLIPやMediaFMなどのマルチモーダル埋め込みを活用し、新規コンテンツのコールドスタート問題を解決し、アートワーク・ビデオプレビューのパーソナライズを高度化した事例を分析します。5つのモデルを1つに統合し、検索意図まで反映するレコメンドシステムの最新アーキテクチャを解説します。
記事を読む →
2026-08-30
予測モデルの精度が落ちたとき、漫然と再学習(Retrain)を行うのは危険です。Airbnbのデータサイエンスチームは、その行為を「リフィット(Refit)」「リスペック(Respecify)」「ホールド(Hold)」の3つに区別し、状況に応じた判断を行っています。本記事では、その判断基準と実践的な教訓を解説します。
記事を読む →2026-08-29
エンタープライズAI導入のスケーラビリティを左右するエージェントロジックの役割を、IBMの具体的な実装事例を交えて解説します。コンテキスト最適化がもたらす性能向上とコスト削減のメカニズムを紹介します。
記事を読む →
2026-08-27
NYCBS(ニューヨークがん・血液専門医機構)がAmazon Connect専用インスタンスへ移行し、患者登録率を54%改善した事例を基に、ヘルスケア業界におけるクラウドコンタクトセンター設計の要点を徹底解説します。
記事を読む →2026-08-22
LLM予測を人間の反応の代わりに使用するA/Bテストの妥当性と条件を分析します。Upworthyデータセットを用いた実験では、LLM出力はバイアスを持ち、キャリブレーション手法によって効果推定が変わることが示されました。本質的に、将来の新しい処置に対する検証は不可能であるという限界を解説します。
記事を読む →
2026-08-21
AirbnbのFlexible Authentication事例を通じて、「まず識別、次にチャレンジ」モデルとサーバードリブン画面レンダリングが、ログイン成功率を向上させ、コードを60%削減した理由を解説します。
記事を読む →
2026-08-18
LLMエージェントやフレームワークを使わずに、純PythonとOpenAI Responses APIで透明性が高く保守しやすいLLMワークフローを設計する方法を、実践例とともに解説します。エージェントが必要な場面とフレームワークの価値も議論します。
記事を読む →2026-08-16
量子コンピュータの脅威が現実味を帯びる中、NISTが標準化したML-DSAから競争中のSQIsign、MAYO、SNOVAまで、ポスト量子署名アルゴリズムの性能をデータで比較。2029年までの現実的な移行ロードマップを提示します。
記事を読む →2026-08-14
ユーザーは新しいツールではなく、既存のワークフローに自然に溶け込む「静かなAI(Quiet AI)」を求めています。本記事では、AIファーストの落とし穴を指摘し、フォルダ指示(Folder Instructions)の概念を通じて、実質的な生産性向上につながる設計原則と実践的な適用方法を解説します。
記事を読む →
2026-08-12
AIモデルの性能は、単に精度だけでは決まりません。ハードウェアとの整合性が実際のサービス品質を左右します。本記事では、LLMの構造的選択(H、H、L)がGPUのスループットと応答性に与える影響を分析し、実務で即適用できる7つの設計ガイドラインを提示します。
記事を読む →2026-08-05
クラウド接続が不安定な産業現場で生成AIを運用するためのオフラインファーストアーキテクチャを、AWSサービスを用いて解説。モデルカスタマイズからエッジ配備、ローカル推論、フィードバックループまでの全体像をコードと図で詳しく説明します。
記事を読む →
2026-08-04
Netflixが大規模な時系列データを処理するために構築したシステムで直面した「ワイドパーティション(Wide Partition)」問題と、その解決策を詳しく解説します。テーブル単位ではなくID単位でパーティションを動的に分割する手法と、その効果、そして実務への適用における注意点を紹介します。
記事を読む →2026-08-03
埋め込み空間が言語ではなくタスクレジスタ(エンジニアリング)で構造化されており、技術用語が混ざると韓国語で応答する現象を実験で分析したインサイト。
記事を読む →
2026-08-02
AIネイティブ時代におけるアセット分類の課題と解決策を、Metaの大規模実装事例から解説。コンテキスト構築、LLM推論、決定論的ルールへの蒸留という3段階のパターンを詳述します。
記事を読む →
2026-07-27
エアカナダのチャットボット事故からAmazonの採用AIバイアスまで。確率的思考でプロダクトを設計し、Human-in-the-Loopとレジリエンスを実現する実践フレームワーク。
記事を読む →2026-07-22
Spotify Engineering Blogのインサイトを基に、LLM評価(Evals)とA/B実験が「フォーク」ではなく「ファネル」関係であるべき理由と、実務での適用方法を解説します。
記事を読む →
2026-07-20
CSS transform translate()の基本構文から、レイアウトへの影響、ホバー時のちらつき問題の解決策、ブラウザサポート状況までを実践的に解説します。
記事を読む →
2026-07-19
Netflixが抱えるデータプラットフォームのスケール課題——個別テーブル単位のACL管理と人間のIDに紐づくワークロード——を、Data Projectsというプロジェクト単位のコンテナと合成IDで解決したアーキテクチャを詳細に解説します。
記事を読む →
2026-07-16
AIモデルがユーザーの指示に従わず、外部に情報を漏洩する「内部告発(Whistleblowing)」現象に関する最新研究を分析。単なるバグではなく、アライメント問題の核心であり、むしろ安全なAIのために必要な機能であるという反論まで深く掘り下げます。
記事を読む →
2026-07-13
Airbnbがゲスト/ホスト間のソーシャル接続を促進しながらプライバシーを保護するために導入したUserとProfileの分離アーキテクチャ、コンテキストアウェアなProfile ID、権限システムHimeji、AIリファクタリングまでの実践的知見を共有します。
記事を読む →2026-07-12
Azure IaaSにおける可用性ゾーン、VMSS、ストレージ冗長化、ネットワークフェイルオーバーを活用した回復力のあるインフラ設計の実践ガイド。障害を前提とした設計思想からIaC、Site Recoveryによる運用自動化まで解説します。
記事を読む →
2026-07-08
Cloudflareが100PB規模のClickHouseクラスターでパーティショニング変更後に経験したパフォーマンス低下の原因を分析し、3つのパッチ(共有ロック、ベクターコピー遅延、二分探索)で解決したプロセスを詳しく解説します。クエリプランナー段階のミューテックス競合とデータパート増加によるボトルネックを、実際のフレームグラフとともに説明します。
記事を読む →2026-07-07
NetflixがMLモデル、パイプライン、実験、特徴量、データセットを単一のグラフで接続したMetadata Service(MDS)アーキテクチャを詳細に解説します。分散したML環境において、発見(Discovery)、系統(Lineage)、影響分析(Impact)をどのように実現したのか、実務への応用ポイントと共に紹介します。
記事を読む →2026-07-05
クラウド上のAI、クラウドネイティブ、ミッションクリティカルなワークロードのパフォーマンスを左右するのは、コンピューティング・ストレージ・ネットワーキングの有機的な連携です。Azureがシステムレベルでパフォーマンスを設計する方法と実務適用のポイントを整理しました。
記事を読む →2026-06-28
Azure API ManagementがIDC MarketScapeでリーダーに選出された背景と、AI時代におけるAPIガバナンスの重要性、そして実践的な適用方法について詳しく解説します。
記事を読む →2026-06-27
Metaが長年維持してきたWebRTCの内部フォークを捨て、最新アップストリームベースのモジュラーアーキテクチャへ移行したプロセスを詳解。デュアルスタック構成、シムレイヤー設計、自動リネームスペーシングなど、実務に直結するインサイトを提供します。
記事を読む →
2026-06-26
ユーザーが自社サイトの検索ではなくGoogleを使う理由を情報アーキテクチャ(IA)の観点から分析し、検索ログ監査からファジーマッチング、セマンティックスキャフォールディングまで実務にすぐ使える4ステップフレームワークを解説します。
記事を読む →2026-06-25
Netflixが全ライブイベントのエンコード方式をVBR(可変ビットレート)に切り替えた事例を分析。ビデオエンコード最適化とトラフィック安定性の微妙なバランス、そして実務のインフラエンジニアに役立つ知見を解説します。
記事を読む →2026-06-20
Metaのセキュリティチームが、数百万行のAndroidコードをAIで自動マイグレーションし、脆弱性を未然に防ぐ戦略を解説。Secure-by-Designフレームワークと生成AIを組み合わせた革新的なアプローチを実務目線で分析します。
記事を読む →2026-06-18
AWS と Snowflake が共同で開発した Custom Well-Architected Framework Lens を紹介します。従来別々に実施していたセキュリティ、ガバナンス、コスト最適化のレビューを1つのフレームワークに統合し、生産性を向上させ、コンプライアンス証跡を簡素化する方法を実務観点から解説します。
記事を読む →
2026-06-17
Spotifyが7万以上のデータセットを単一のLLMに詰め込むのではなく、ドメインエキスパートがキュレーションした「コンテキストレイヤー」で信頼できるデータアシスタントを構築した方法を詳しく解説します。クラスターモデル、ヘルススコア、フィードバックループまで、実践的なインサイトをお届けします。
記事を読む →2026-06-13
Claude CodeやCodexなどのAIコーディングエージェントを最大限に活用するための4つの実践テクニックを紹介します。プロンプトの工夫からフック設定、トークン消費戦略まで、すぐに適用可能な方法を解説します。
記事を読む →2026-06-05
Metaの容量効率(Capacity Efficiency)プログラムが、統一されたAIエージェントプラットフォームを通じてどのように数百MWの電力を節約し、エンジニアの手作業時間を劇的に削減したか、そのアーキテクチャと実践的なユースケースを詳しく解説します。
記事を読む →2026-05-27
Netflixはポリレポ環境で358のArchUnitルールを5,000以上のリポジトリに適用し、約100万件のイシューを検出しました。この記事ではその秘密であるNebula ArchRulesプラグインの設計思想と実践的な適用方法を詳細に解説します。
記事を読む →2026-05-26
Vercel Workflowの最新パフォーマンス改善情報と、サーバーレスワークフローにおけるボトルネックの発見・最適化の実践ノウハウを共有します。
記事を読む →
2026-05-25
デザイン原則を単なるガイドラインではなく、チームの共有目的と価値を文書化するツールとして捉える実践ガイドです。原則を策定する8ステップのワークショップと実際の事例を紹介します。
記事を読む →2026-05-23
Airbnbがサードパーティベンダーから脱却し、JanusGraph + DynamoDBをベースにした自社管理型グラフインフラを構築したプロセスを詳解。70億ノード・110億エッジを処理する実践的アーキテクチャと、レイテンシ削減のための最適化テクニックを紹介します。
記事を読む →
2026-05-14
モーダルとページ遷移、どちらを選ぶべきか?UX決定木と実務適用のポイントをわかりやすくまとめました。
記事を読む →2026-05-12
NetflixのMLモデルサービングプラットフォームの中核であるトラフィックルーティングアーキテクチャを、SwitchboardとLightbulbの2世代にわたって分析。秒間100万リクエスト、数百のモデルを単一APIで抽象化した設計思想と実務的な教訓を解説します。
記事を読む →2026-05-11
BASFとCircularTreeがAWS上に構築したPACIFICプラットフォームが、Catena-Xデータスペースにおいてマルチテナント環境でのデータ主権を保証しながら、製品カーボンフットプリント(PCF)交換を自動化した方法を詳しく解説します。IAMベースのテナント分離、EDC認証トークン、統合モジュール設計など、実践的なアーキテクチャインサイトを提供します。
記事を読む →2026-05-02
3.5億ユーザー向けに14億件のLLMレポートを事前生成したSpotify Wrapped 2025のアーキテクチャを詳細解説。モデル蒸留、カラム指向ストレージ設計、プロンプトエンジニアリング、大規模評価フレームワークまで、実務に直結する知見をまとめました。
記事を読む →2026-04-29
NetflixがMedia Production Suite (MPS) とFilmLight API (FLAPI) を活用し、グローバルプロダクションにおけるカメラファイル処理、メタデータ検査、VFXプレート生成を自動化・弾力的にスケールする方法を詳解します。
記事を読む →2026-04-28
SpotifyがバックグラウンドコーディングエージェントHonkとBackstage Fleet Managementを活用し、1,800のダウンストリームデータパイプラインを6ヶ月で移行したプロセスと教訓を共有します。約10エンジニアリング週間分の手作業を自動化した方法、コンテキストエンジニアリングの重要性、そしてデータ環境標準化の必要性を実例を通じて解説します。
記事を読む →2026-04-23
Metaは一日数百億回実行されるFFmpegの内部フォークを、最近の公式バージョンで完全に置き換えました。並列エンコーディングとリアルタイム画質分析という二つの核心機能がどのようにオープンソースエコシステムに貢献したのか、大規模運用からの教訓を解説します。
記事を読む →2026-04-21
ソフトウェアエンジニア/データサイエンティストからAIエンジニアへ転身するための5ステップ実践ガイド。基礎スキル、プロジェクト構築、就職活動までの具体的な手法を解説します。
記事を読む →2026-04-21
メタの「Advanced Browsing Protection(ABP)」は、エンドツーエンド暗号化されたチャット内の悪意あるリンクを、ユーザーのプライバシーを侵害することなく検出するシステムです。PIR、OPRF、Confidential Computingなど、多層的な暗号技術とインフラがどのように連携するか、その技術的洞察を詳解します。
記事を読む →2026-04-14
AIコーディングエージェントの生産性向上の裏に潜むプロダクションリスクを解説し、安全に活用するためのエンジニアリングフレームワークと実行可能なガードレールの構築方法を共有します。
記事を読む →2026-04-10
AWS EKS Auto Modeと統合セキュリティサービスを活用し、複雑なコンテナ環境を自動化、運用負荷を大幅に削減した企業の実践事例を詳解します。
記事を読む →
2026-04-08
PantoneがAzure Cosmos DBを基盤としたエージェントAIアーキテクチャにより、カラーパレット生成ワークフローを革新した実践的なケーススタディと、そこから得られた開発者向けのインサイトを解説します。
記事を読む →2026-04-07
単一障害がシステム全体を麻痺させていたモノリスアーキテクチャから、AWS EventBridgeを活用して毎秒2000イベントを99.99%の成功率で処理するレジリエントなシステムへ変換した旅程と、その核心的な知見を共有します。
記事を読む →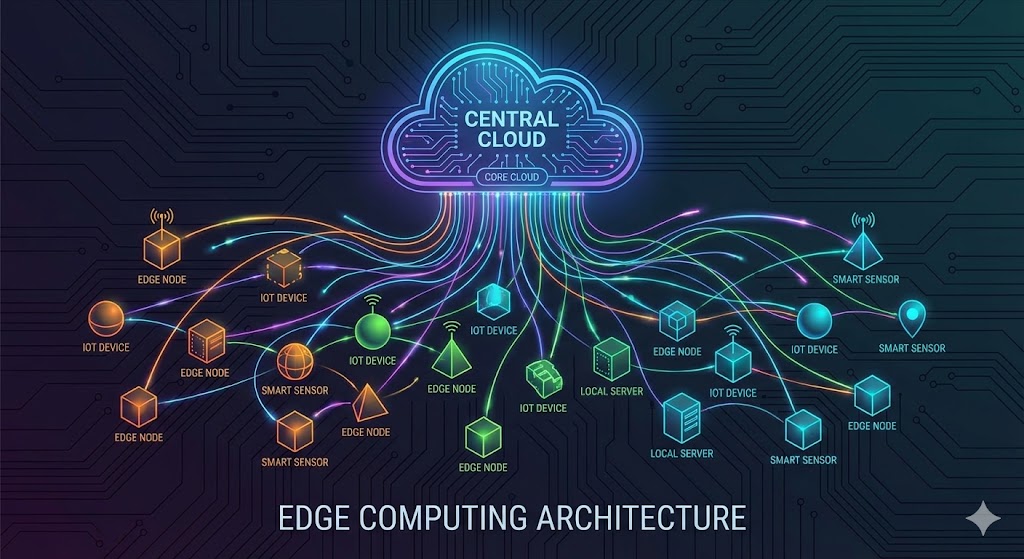
2026-03-26
グローバル金融機関サンタンデールが「Catalyst」プラットフォームにより、クラウドプロビジョニング時間を90日から数時間に短縮。AIエージェントからデータプラットフォームまでを標準化した実践的ケーススタディを解説します。
記事を読む →2026-03-23
Metaが長年維持してきた内部FFmpegフォークを、どのようにアップストリームに貢献しながら廃止したのか。大規模VOD/ライブストリーミングパイプラインの効率化事例を紹介します。
記事を読む →
2026-03-20
複雑な条件付きロジックを持つマルチステップフォームを実装する際の、コンポーネント中心(RHF+Zod)とスキーマ中心(SurveyJS)アプローチの実質的な違いと選択基準を比較分析します。
記事を読む →2026-03-19
Spotifyの実例を通じて、大規模コードベースでマージ可能なプルリクエストを安定して生成するためのプロンプト設計とエージェントツール設計に関する深い考察を共有します。
記事を読む →2026-03-18
1日76億回提供されるセキュリティ認証UIを、より明確でアクセシブルなものに再設計したCloudflareの取り組み。その設計プロセスと実践的な知見を共有します。
記事を読む →
2026-03-18
決済プラットフォームConveraが、Amazon Verified PermissionsとCedarポリシー言語を活用して、スケーラブルで属性ベースの高度な認可モデルを構築したアーキテクチャの詳細と実装のポイントを解説します。
記事を読む →
2026-03-18
NetflixがSpinnakerの複雑なオーケストレーションからTemporalのDurable Executionプラットフォームへアーキテクチャを移行し、デプロイの信頼性を劇的に向上させた事例を詳細に解説します。
記事を読む →2026-03-11
アルゴリズムのバッチ処理、メモリレイアウトの見直し、純粋なJavaでのSIMD活用に至るNetflixの実践的な最適化の過程を解説します。
記事を読む →
2026-03-05
JavaScriptライブラリに依存した従来のツールチップ実装から、ブラウザネイティブのPopover APIへ移行する際の考察と実践的な知見をまとめました。
記事を読む →
2026-03-04
Jiraからの脱却、統一ダッシュボードの構築、そして自動化ロボットの導入まで。大規模アプリリリース管理の実践的洞察を解説します。
記事を読む →2026-02-24
単一のAIモデルではなく、専門化されたエージェントが協調するシステムが、メディアプランニングのような複雑なビジネスワークフローをどのように分解するかについての実践的な考察です。
記事を読む →2026-02-17
NVIDIA AI Red Teamの提言に基づく、AIコーディングエージェントがもたらすリスクを軽減するOSレベルのサンドボックス戦略と必須セキュリティ制御について解説します。
記事を読む →2026-02-10
Spotifyのアーキテクチャに基づき、MLベースのパーソナライゼーションシステムと実験プラットフォームを分離すべき技術的・実践的理由を解説します。
記事を読む →2026-02-01
LLMが生成する多段階のカスタマージャーニーの質を、事前定義された分類法に基づいて構造的に評価するCDPフレームワークの概念と実践的な適用方法について詳しく考察します。
記事を読む →
2026-01-31
印刷時代の概念である「ピクセルパーフェクト」がなぜ現代のWebに有害であるのか、そして「デザイン意図」の実装へと焦点を移す方法についての考察を共有します。
記事を読む →2026-01-24
人間の監督なしに数千のコードベースを自動変更するAIエージェントを設計する際、信頼性を確保する方法に関するSpotifyのインサイトを共有します。
記事を読む →
2026-01-22
Web Directions Dev Summit 2025参加記。フレームワークへの依存の見直し、アクセシビリティの本質の考察、AI時代の開発者の役割についての深い気づきを共有します。
記事を読む →