El Problema: Los Data Lakes No Están Hechos para Consultas Puntuales
Los data lakes son geniales para análisis por lotes, pero cuando necesitas obtener un solo registro de usuario—por ejemplo, para que un agente de IA responda "¿qué estaba escuchando el verano pasado?"—motores de consulta tradicionales como Trino o BigQuery añaden segundos de overhead. Incluso con almacenamiento en la nube ahora ofreciendo latencia de milisegundos de un solo dígito, el cuello de botella es la planificación de la consulta, no el almacenamiento.
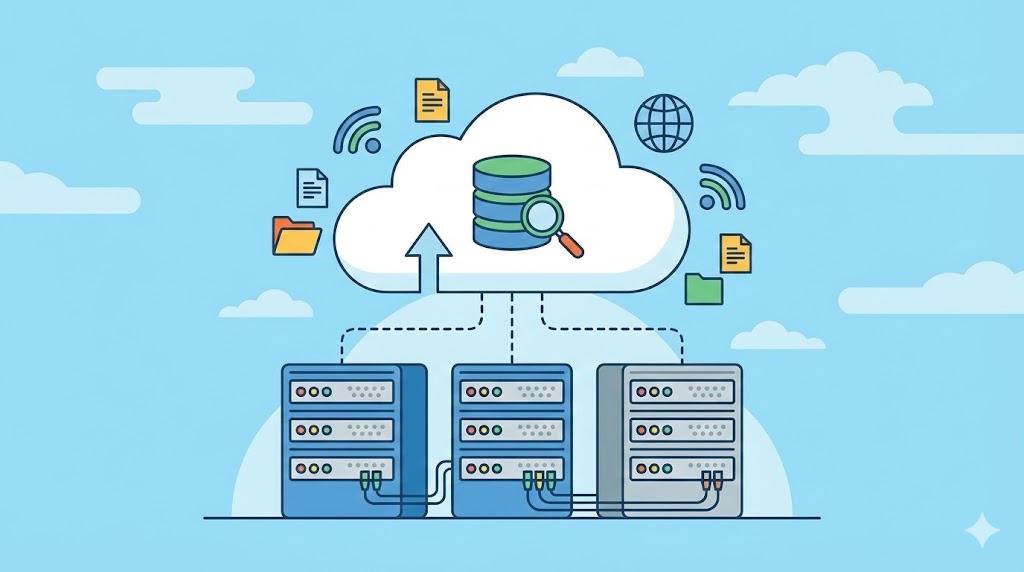
Spotify enfrenta este desafío a escala de exabytes. Mientras Bigtable maneja cargas de trabajo en línea a nivel de petabytes, la mayor parte de los datos reside en GCS. La solución no es copiar todo a un KV store—eso sería prohibitivamente caro. En cambio, construyeron un índice externo que hace que los archivos Parquet existentes sean accesibles aleatoriamente.
La Idea Central: Reemplaza Escaneos con Búsquedas
El problema fundamental con Parquet es la cadena de lecturas dependientes: obtener el pie de página, analizar metadatos de row group, escanear la columna de clave, localizar páginas. Cada paso requiere un round-trip al almacenamiento. RAP elimina esta cadena usando un índice precomputado que mapea cada clave directamente a archivo y número de fila.
# Pseudo-código para consulta puntual basada en RAP
index = load_external_index("user_id")
file_loc, row_num = index.lookup(user_id)
# Ahora emite una sola lectura de rango para obtener exactamente los bytes necesarios
page_data = read_range(file_loc, offset=row_num.page_offset, length=row_num.page_size)
result = decode_page(page_data)
El índice es un multimapa: cada clave puede apuntar a múltiples entradas en diferentes archivos. El tamaño del índice es aproximadamente el 1% de los datos fuente (terabytes de índice para petabytes de datos), lo cual es manejable y se distribuye bien mediante hash bucketing.
Optimizaciones Que Importan
Una vez que tienes un índice externo, puedes optimizar los archivos Parquet para consultas puntuales sin romper la compatibilidad con análisis por lotes. Las optimizaciones clave caen en tres categorías:
1. Concentrando Datos de Clave
- Ordenar por clave: Asegura que las filas de la misma clave sean contiguas, minimizando páginas a leer.
- Co-agrupación: Usa
ARRAY_AGGpara almacenar todos los valores de una clave en una fila—sin necesidad de orden. - Particionamiento más grueso: Particiones semanales en lugar de diarias reducen el número de archivos que una clave abarca.
2. Reduciendo Bytes Leídos
- Una página por clave: Descarga páginas en límites de clave, haciendo que cada página sea exactamente los datos de una clave.
- Reinicios de frame ZSTD: Mantén tamaños de página convencionales pero comprime cada clave como un frame separado, permitiendo direccionamiento directo.
- Alineación de almacenamiento: Rellena con frames ZSTD skippable para alinear lecturas a límites de bloque.
3. Reduciendo Operaciones de Lectura
- Blobs/Variants: Almacena campos de consulta puntual como una sola columna JSON o Variant—una lectura por archivo.
- Intercalación de columnas: Coloca físicamente columnas para cada clave juntas, permitiendo una sola lectura contigua.
- Índices de cobertura: Coloca valores pequeños directamente en el índice, eliminando lecturas de almacenamiento.
Trade-offs y Limitaciones
Estas optimizaciones no son gratis. Una página por clave puede inflar el PageIndex. Los reinicios de frame ZSTD fuerzan codificación PLAIN, lo que puede reducir la compresión. Intercalar columnas perjudica los escaneos de una sola columna añadiendo espacio muerto. Los índices de cobertura aumentan el tamaño del índice. Los equipos deben elegir cuidadosamente qué optimizaciones aplicar según sus patrones de acceso.
Próximos Pasos
RAP es un patrón prometedor, pero requiere un esfuerzo de ingeniería significativo para implementarlo. Para equipos que lo consideren, comienza analizando tus patrones de consulta puntual e identifica qué optimizaciones aportan más valor. También explora técnicas complementarias como índices secundarios para búsquedas multidimensionales.
Para más contexto sobre tendencias modernas de ingeniería de datos, revisa esta vista previa de Python 3.15 o aprende sobre layouts CSS zigzag.
Inmersión Profunda: El Índice Externo
El índice externo es el corazón de RAP. Se construye leyendo pies de página y ubicaciones de páginas, escaneando columnas de clave y escribiendo un mapeo. Construirlo es un proceso por lotes que se ejecuta en nuevos datos a medida que llegan.
# Ejemplo: Construyendo un fragmento de índice para un nuevo archivo Parquet
from rap import IndexBuilder

builder = IndexBuilder(key_column="user_id")
# Lee el pie de página y las ubicaciones de página
metadata = read_parquet_footer(file_path)
# Escanea la columna de clave para encontrar row groups
row_groups = scan_key_column(metadata, key_column="user_id")
# Escribe entradas de índice
for row_group in row_groups:
    builder.add_entry(key=row_group.key, file=file_path, rows=row_group.rows)
builder.write_fragment("index/user_id/2026-07-01.rap")
El índice es append-only, con fragmentos por ejecución de pipeline. Este diseño evita contención y permite actualizaciones incrementales.
Consideraciones Prácticas y Errores Comunes
Tamaño y costo del índice: Indexar petabytes produce terabytes de índice. Aunque es más barato que duplicar datos en un KV store, no es gratis. Considera estrategias de particionamiento para mantener el tamaño del índice manejable.
Trade-offs columna vs. orientado a filas: Algunas optimizaciones (como intercalación) hacen que el archivo sea menos eficiente para escaneos columnares tradicionales. Si tus datos se usan mucho tanto para análisis como para consultas puntuales, quizás necesites equilibrar entre ambos.
Madurez de herramientas: Esta es una solución personalizada de Spotify. Las alternativas de código abierto pueden no ofrecer el mismo nivel de optimización. Espera invertir en construir tus propias herramientas.
Próximo camino de aprendizaje: Para profundizar, estudia internals de Parquet, compresión ZSTD y estructuras de datos de índice. También mira cómo se resuelven problemas similares en otros sistemas como Apache Druid o ClickHouse.
Conclusión
RAP muestra que los data lakes pueden servir cargas de trabajo interactivas sin una capa de servicio separada. Al colapsar lecturas dependientes en una sola búsqueda, desbloquea acceso de baja latencia a exabytes de datos. La conclusión clave: comienza con un índice externo, luego optimiza tu layout de archivo incrementalmente.
Si estás construyendo agentes de IA que necesitan recuperar contexto de usuario, este es un patrón que vale la pena estudiar. Para más temas relacionados, mira la vista previa de Python 3.15 o la técnica de CSS zigzag.